https://arxiv.org/pdf/2106.09685
거대 언어 모델을 적은 비용으로 파인튜닝하기 위한 방법
서론
많은 NLP 응용은 하나의 대규모 사전학습 모델을 여러 다운스트림 태스크에 맞게 파인튜닝하는 방식에 의존한다. 파인튜닝은 모델의 모든 파라미터를 업데이트하므로, 새 모델도 원래 모델과 파라미터 수가 같다. 모델이 커지면서 이는 GPT-2, RoBERTa-large에서는 불편함 수준이었지만, GPT-3에서는 태스크마다 175B 사본을 저장하고 배포해야 하는 심각한 문제가 되었다.
| 모델 | 파라미터 수 |
|---|---|
| RoBERTa-base | 125M |
| RoBERTa-large | 355M |
| GPT-2-large | 774M |
| GPT-3 | 175B |
이를 해결하기 위해 일부 파라미터만 적응시키거나 태스크별 외부 모듈을 학습하는 방법이 연구되었다. 이렇게 하면 태스크마다 작은 파라미터만 저장하면 되므로 배포 효율이 높아진다. 그러나 이런 방법들은 모델 깊이를 늘려 추론 지연을 유발하거나, 사용 가능한 입력 시퀀스 길이를 줄인다. 또한 파인튜닝 성능에 미치지 못하는 경우가 많아 효율과 품질 사이에서 하나를 포기해야 했다.
선행 연구에서 거대 모델이 파라미터는 많아도 실제로 의미 있게 움직이는 방향은 적다는 것을 보였다(낮은 내재 차원). 저자들은 여기서 한 걸음 더 나아가, 파인튜닝할 때 가중치에 더해지는 변화량 ΔW도 정보가 적을 것(낮은 내재 랭크)이라고 가정한다.
본론
기존 방법의 한계
1. Adapter
Transformer의 각 블록 내부에 작은 레이어를 직렬로 추가하고 이 레이어만 학습한다. 파라미터는 적지만 기존 레이어와 동시에 계산할 수 없어 순차 계산 단계가 늘어나므로 추론 지연이 생긴다. 배치가작아 전체 계산량이 적으면 연산량보다 거쳐야 하는 단계 수가 시간을 좌우하기 때문에 배치 크기가 1, 시퀀스 길이가 128인 온라인 추론에서는 GPT-2 medium 기준 30% 이상 느려졌다.
반면 배치 크기나 시퀀스 길이가 크면 GPU 사용률이 이미 높아 Adpater의 추가 연산이 전체 시간에서 차지하는 비중이 작으므로 지연이 상대적으로 줄어든다. 또한 모델을 여러 GPU에 나눠 올리면(샤딩) 늘어난 깊이만큼 GPU 간 동기화 연산이 많아져 문제가 더 심해진다.
2. Prefix tuning
입력 앞에 학습 가능한 지시문 토큰을 끼워 넣는다. 모델의 입력 길이에 상한이 있으므로(GPT-3 2048개) 지시문 토큰이 차지한 만큼 실제 입력을 넣을 칸이 줄어든다. 또한 최적화가 어렵고, 파라미터를 늘려도 성능이 꾸준히 오르지 않는다.
제안 방법
기존: $$h=W_0x$$
LoRA: $$h= W_0x + BAx$$
$$
W_0: d\times k\ \ \ \ B: d\times r\ \ \ \ A: r\times k\ \ \ \ (r≪ min(d, k))
$$
- 파인튜닝: W₀에 ΔW를 더하는 작업 W =W₀ + ΔW
- ΔW는 크기만 크고 담긴 정보는 작다.(랭크가 낮다)
- ΔW를 통째로 학습하지 않고 얇은 행렬 2개로 쪼개 학습한다.
| 크기 | ΔW 그대로 저장 | B, A로 저장(r = 1) |
|---|---|---|
| 2x2 | 4개 | 4개 |
| 12,288x12,288 (GPT-3) | 약 1억 5천만 개 | 약 2만 5천 개 |
예를 들어 [[1, 2], [3, 6]]은 두 번째 행이 첫 번째 행의 3배이므로 랭크 1이다. 따라서 B = [[1], [3]] (2×1)과 A = [[1, 2]] (1×2)의 곱으로 쪼갤 수 있다. 2×2에서는 저장할 숫자가 4개로 같지만, r이 1일 때 d×d에서는 d²개 대신 2d개만 저장하면 된다.
학습 방법
준비
- 사전학습 모델을 불러오고 모든 가중치를 고정
- LoRA를 붙일 행렬 선택(논문 기본값: 각 층 attention의 W_q, W_v)
- 고른 행렬마다 B, A를 생성
- A: 작은 무작위 가우시안 값
- B: 전부 0
시작 시점이 ΔW=BA=0이므로 모델이 사전학습 모델과 똑같이 출발하기 위함, 둘 다 0이면 그래디언트가 흐르지 않아 하나는 무작위로 둠
학습 스텝
1. forward(LoRA가 붙은 모든 층)
$$
h=W_{0}x + (\alpha/r)\cdot B(Ax)
$$
$x$: 입력 벡터(k차원)
$W_0x$: 사전학습 모델의 원래 출력
$Ax$: 입력을 r차원으로 압축(입력이 A 패턴과 얼마나 닮았나?를 r개로 요약)
$B(Ax)$: 그 r개의 숫자를 다시 d차원으로 펼침(닮음 정도를 각 출력에 얼마씩 더할지)
$\alpha/r$: 보정의 세기, $\alpha$는 상수로 학습률을 조정하는 것과 비슷한 역할, r로 나누는 것은 r이 변해도 보정 크기가 비슷하게 유지
$h$: 두 결과를 더한 최종 출력
2. 손실 계산
$$
L=-\sum_{t}logP(y_t|x, y_{<t})
$$
- 정답 문장 y를 한 토큰씩 봄
- 입력 x와 앞부분 정답을 보고 다음 토큰으로 정답 $y_t$를 예측할 확률
- 일반 GPT 손실 함수와 동일
3. Backward: 그래디언트 계산
$$
\begin{aligned}
\text{B: } & (\alpha / r) \cdot g \cdot (Ax)^T \quad (g \rightarrow \text{출력 } h \text{에 대한 그래디언트}) \\
\text{A: } & (\alpha / r) \cdot (B^T g) \cdot x^T \\
\text{W}_0\text{: } & \text{계산 X}
\end{aligned}
$$
- B는 압축된 입력 $(Ax)$과 원하는 출력 변화(g)를 보고 업데이트
- A는 원래 입력$(x)$과 B를 거꾸로 통과한 원하는 변환$(B^Tg)$를 보고 업데이트
4. 업데이트 대상
| 항목 | 필요 | 크기(GPT-3) |
|---|---|---|
| $W_0$ | O | 약 350GB |
| B, A의 그래디언트, Adam 상태 | O | 아주 작음 |
| $W_0$의 그래디언트, Adam 상태 | X | 수 백 GB |
| 활성값 | O | 배치, 입력 길이에 비례 |
학습 중 필요한 GPU 메모리는 전체 파인튜닝 시 약 1.2TB이다. LoRA는 W_0의 그래디언트와 Adam 상태를 저장하지 않고 B, A만 업데이트하므로 약 350GB로 줄어든다.
학습 후 저장하는 체크포인트도 전체 가중치가 아닌 A, B만 저장하면 되므로, 체크포인트 파일 크기가 350GB → 약 35MB로 줄어든다.(r=4, W_q·W_v 기준)
또한 대부분의 파라미터에 대해 그래디언트를 계산하지 않으므로, GPT-3 기준 GPU 당 처리량이 늘어 같은 양을 학습하는 데 걸리는 시간이 약 25% 빨라졌다.(V100 GPU당 32.5 → 43.1 tokens/s)
학습 시 VRAM 사용량(GPT-3)
가중치: 전체 모델의 가중치(약 350GB)가 모두 로드된다.
Adam 상태: 그래디언트 평균(m)과 제곱평균(v)이 파라미터마다 하나씩 저장된다. 첫 step 시 생성되어 학습 내내 유지되고, 매 step마다 in-place로 갱신된다. 따라서 배치 크기와 무관하다.
그래디언트: backward 시 각 파라미터마다 계산된다. 배치의 기울기 평균으로 파라미터당 하나만 저장된다. step에서 Adam이 사용한 뒤 메모리가 해제된다.
활성값: forward 시 각 레이어의 중간 출력을 backward에서 사용하기 위해 저장된다. 배치 크기 및 시퀀스 길이에 비례해 메모리 차지되며, backward 진행 중 메모리가 해제된다.
추론 방법
$$
W=W_0+(\alpha/ r)\cdot BA
$$
학습 후 각 레이어에서 한 번만 계산한다. 즉 $h=Wx$로 원래 모델과 계산량이 동일하다.
$$
W_{new}=W-(\alpha/ r)\cdot B_{\text{task1}}\cdot A_{\text{task1}} +(\alpha/ r)\cdot B_{\text{task2}}\cdot A_{\text{task2}}
$$
태스크 전환 시 현재 보정을 빼고 다른 태스크 보정을 더해 전체 가중치를 재로드하지 않아도 된다.
실험 결과
기존 방법과 성능 비교
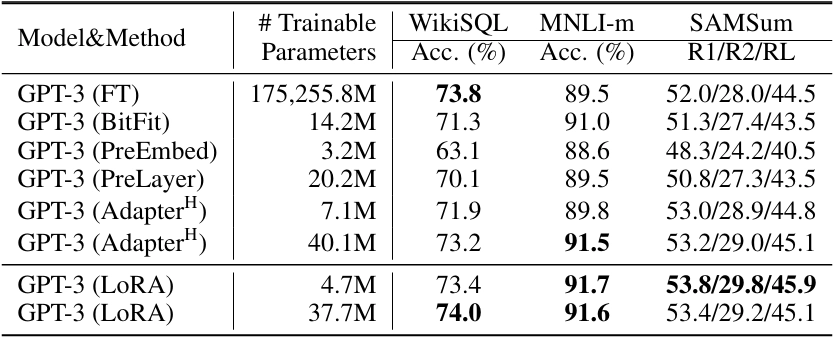
RoBERTa, DeBERTa, GPT-2, GPT-3에서 LoRA를 전체 파인튜닝 및 기존 방법들과 비교했으며, 모든 모델에서 LoRA는 훨씬 적은 파라미터로 전체 파인튜닝과 비슷하거나 더 좋은 성능을 냈다.
학습 파라미터 수와 성능 비교
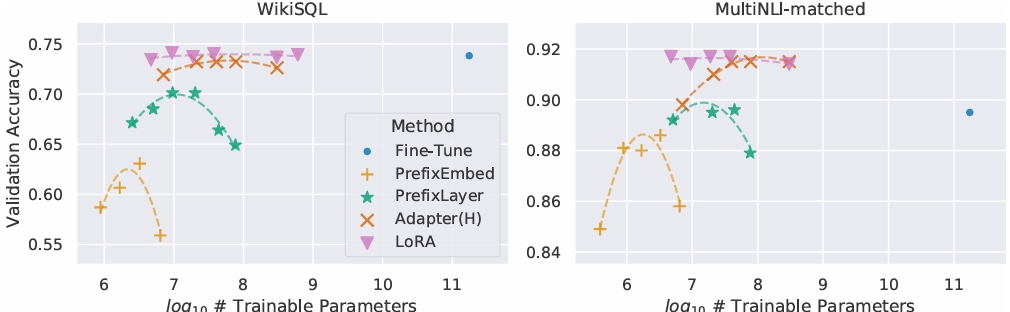
Prefix 계열은 학습 파라미터를 늘리면 오히려 성능이 떨어졌다. 저자들은 특수 토큰이 많아질수록 입력 분포가 사전학습 데이터 분포에서 멀어지기 때문이라고 추측한다. 반면 LoRA는 파라미터를 늘려도 성능이 안정적으로 유지된다.
적은 데이터 비교
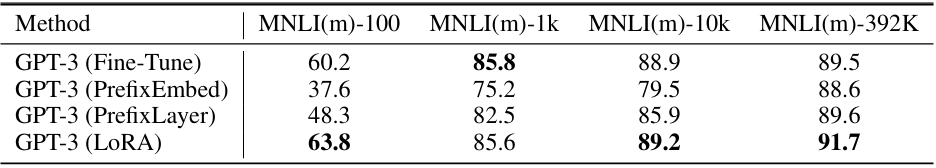
학습 데이터가 100개(MNLI(m)-100)일 때 PrefixEmbed는 무작위로 찍는 수준(33.3%)dp 가까운 37.6%이며, 데이터가 늘수록 격차는 줄어들지만, LoRA는 데이터가 적을 때도 파인튜닝 이상의 성능을 보였다.
분석
어떤 가중치에 LoRA를 붙여야 하는가?
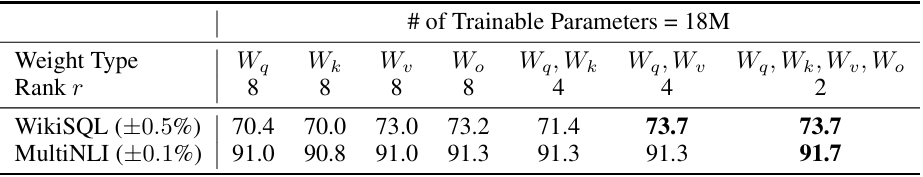
W_q나 W_k 하나에 파라미터를 몰아주면 성능이 낮았고, W_q, W_v를 함께 학습할 때 전반적으로 가장 좋은 성능을 보였다. 즉 같은 파라미터일 때 한 행렬의 랭크를 키우는 것보다 r=4 정도로 여러 행렬에 나눠 붙이는 것이 유리하다.
$\Delta W$는 정말 저랭크인가?
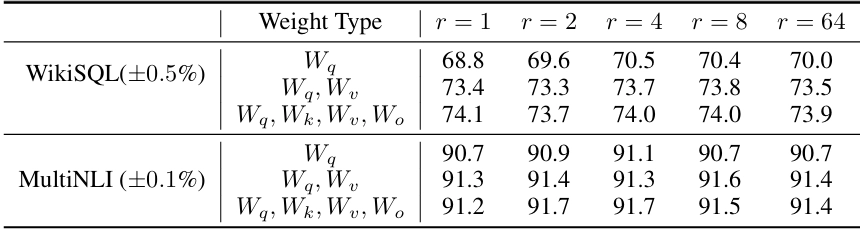
W_q, W_v를 함께 적응시키면 r=1로도 충분했고, r을 64까지 키워도 성능이 오르지 않았다.
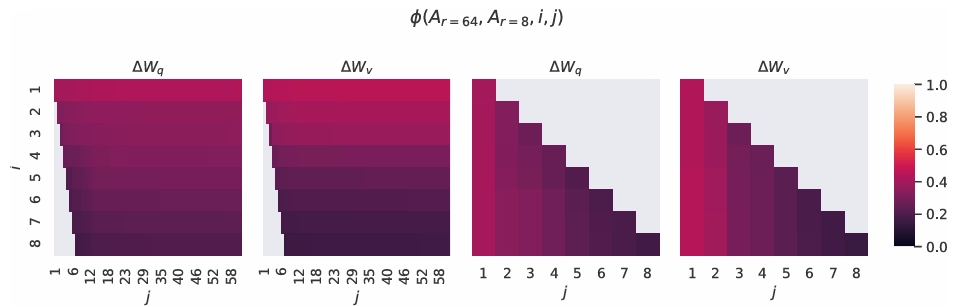
이를 확인하기 위해 같은 모델에서 r=8과 r=64로 각각 학습한 뒤, SVD(특이값 분해)로 각 A 행렬의 방향을 중요도 순으로 정렬해 상위 방향끼리 얼마나 겹치는지(0~1) 비교했다. 가장 중요한 방향 하나는 유사도가 0.5를 넘었지만, 나머지 방향은 거의 겹치지 않았다.. 즉 r을 키워도 의미 있는 방향이 더 생기는 것이 아니며, 추가된 방향은 대부분 학습 중 쌓인 노이즈다.
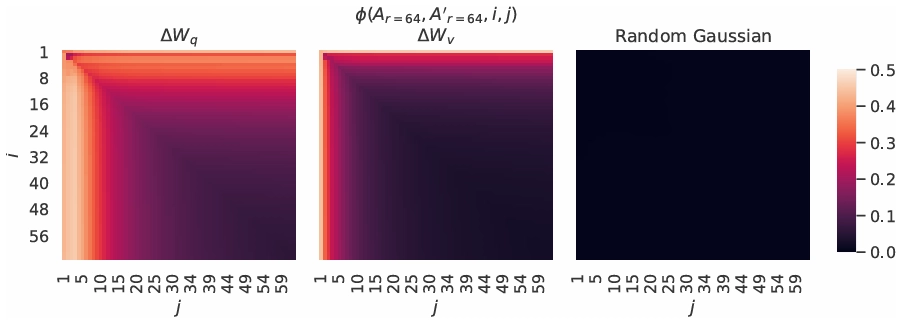
랜덤 시드만 바꿔 두 번 학습한 경우에도 같은 경향이 나타났고, W_q는 W_v보다 공통 방향이 더 많아 내재 랭크가 조금 더 높았다. W_q 단독 적응에 더 큰 r이 필요했던 것과 일치하는 결과다.
단, 작은 r이 모든 태스크에서 통하는 것은 아니다. 예를 들어 사전학습과 다른 언어로 된 태스크라면 전체를 재학습하는 편이 작은 r의 LoRA보다 나을 수 있다.
$\Delta W$와 $W$는 어떤 관계인가?

$||U^TW_qV^T||_F$는 W_q를 특정 r개의 방향에 투영했을 때 남는 크기이다. 즉 W_q가 그 방향들에 얼마나 많이 들어있는지를 나타낸다. ΔW는 무작위 행렬보다 W와 상관관계가 높다. 이는 완전히 새로운 것을 배우는 것이 아닌, W에 이미 있던 특징을 다룬다는 것을 의미한다. 그러나 W에서 가장 강조된 방향(21.67)을 반복하지 않고 W에서 약하게만 존재하던 방향(0.32)을 키운다.
$||W_q||_F = 61.95$는 W_q의 전체 크기를 의미하고 $||\Delta W_q||_F = 6.91$은 LoRA가 $W_q$에 더한 변화량 전체의 크기이다. $\Delta W_q$ 방향에 원래 들어 있던 $W_q$성분은 0.32뿐이므로, LoRA는 그 방향을 약 21.5배(6.91 / 0.32) 증폭한 셈이다. 반면 r=64에서는 $||\Delta W_q||_F = 3.57$이 $\Delta W_q$ 방향의 $W_q$ 성분(1.90)의 약 2배에 그친다. 이는 정말 증폭이 필요한 방향은 몇 개뿐이라는 또 다른 근거가 된다.
결국 LoRA의 적응은 사전학습 때 배웠지만 묻혀 있던, 태스크에 중요한 특징 몇 개를 크게 증폭하는 과정이다. 이는 서론에서 말한 “낮은 내재 랭크” 가설을 뒷받침한다.
결론
LoRA의 출발점은 "파인튜닝 때 더해지는 변화량 ΔW는 크기만 크고 실제 정보는 적다"는 가설이다. 이 가설에 따라 ΔW를 얇은 행렬 B, A의 곱으로 대신 학습했고, GPT-3 기준 학습 메모리를 1.2TB에서 350GB로, 체크포인트를 350GB에서 35MB로 줄이면서도 전체 파인튜닝과 비슷하거나 더 좋은 성능을 얻었다. 학습 후에는 BA를 W₀에 합칠 수 있어 Adapter처럼 추론이 느려지지 않고, Prefix tuning처럼 입력 길이를 차지하지도 않는다.
분석 결과는 이 가설이 실제로 맞다는 것을 보여 준다. r=1~4만으로 충분했고, r을 키워도 추가된 방향은 대부분 노이즈였다. 또한 ΔW는 W에 없던 것을 새로 만드는 것이 아니라, W 안에 약하게 묻혀 있던 태스크 관련 방향을 크게 증폭했다. 즉 거대 모델은 사전학습 단계에서 이미 필요한 특징을 대부분 갖추고 있고, 파인튜닝은 그중 몇 가지를 꺼내 강조하는 작업에 가깝다.
다만 작은 r이 모든 태스크에 통하는 것은 아니며(사전학습과 다른 언어 등), 가중치를 합쳐 두면 여러 태스크의 입력을 한 배치로 처리하기 어렵다. 어떤 행렬에 LoRA를 붙일지도 아직 실험에 의존한다.
'AI' 카테고리의 다른 글
| 배치 정규화 (0) | 2026.10.07 |
|---|---|
| [머신러닝] 01. 머신러닝이란? (0) | 2025.12.20 |
| Hailo Data Compiler 사용 (0) | 2025.12.18 |
| Hailo 관련 SW 설치 (2) | 2025.12.18 |
| [YOLO] COCO 데이터 형식에서 YOLO 데이터 형식으로 바꾸기 (0) | 2025.02.11 |